Arquitectura de datos moderna con Databricks y Power BI: guía práctica
Tu equipo de ventas trabaja con un Excel. El de marketing tiene otro. Finanzas consolida ambos a mano cada lunes. Y cuando alguien del comité pregunta «¿cuánto vendimos en el canal online el mes pasado?», la respuesta tarda dos días y viene acompañada de un «depende de cómo lo mires».
Este no es un problema de personas. Es un problema de arquitectura. Y tiene solución.
En este artículo explico cómo funciona una arquitectura de datos moderna basada en Databricks y Power BI: qué capas la componen, qué hace cada una y por qué este enfoque se ha convertido en el estándar en equipos de datos que trabajan a escala.
El flujo de datos en la mayoría de empresas medianas
Antes de hablar de soluciones, vale la pena describir el problema con precisión. En muchas organizaciones, el flujo de datos real se parece a esto:
ERP / CRM / Ecommerce
        ↓
  Exportaciones manuales (CSV, Excel)
        ↓
  Transformaciones ad hoc (fórmulas, tablas dinámicas)
        ↓
  Informe enviado por correo
Este modelo funciona hasta cierto punto. Pero cuando el negocio crece, aparecen los síntomas:
- Dos departamentos tienen datos distintos para el mismo KPI.
- El informe mensual depende de una sola persona que «sabe cómo se hace».
- Cualquier cambio en el ERP rompe las extracciones manuales.
- Los datos del viernes ya no representan la realidad del lunes.
El problema no es el volumen de datos — es la falta de una capa central que los gobierne.
Qué es una arquitectura de datos moderna
Una arquitectura de datos moderna separa de forma clara tres responsabilidades que en el modelo Excel-manual están mezcladas: ingestión, transformación y consumo.
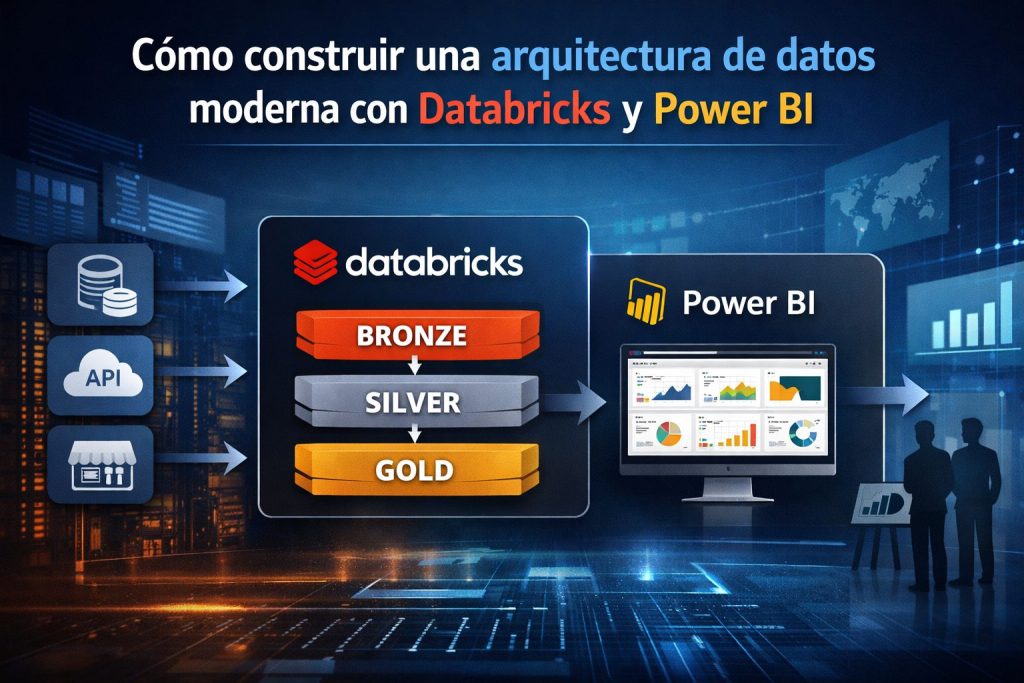
El flujo típico con Databricks y Power BI quedaría así:
Fuentes de datos
(ERP, APIs, Ecommerce, CRM, ficheros)
        ↓
   Databricks
(ingestión + transformación + modelo)
        ↓
     Power BI
  (visualización + capa semántica)
        ↓
  Usuarios de negocio
Databricks es una plataforma cloud de datos y analytics que combina procesamiento SQL, ingeniería de datos y machine learning en un único entorno. Actúa como el motor central: ingiere los datos desde cualquier fuente, los transforma con calidad y los organiza en un modelo analítico. Power BI es la capa de consumo: toma esos datos ya preparados y los convierte en dashboards e informes que los equipos pueden usar sin necesidad de saber SQL.
Por qué Databricks: No es la única plataforma posible (Snowflake, BigQuery, Synapse son alternativas válidas), pero Databricks destaca por su capacidad de combinar ingeniería de datos, machine learning y SQL analytics en un único entorno. Si el equipo va a crecer, es una apuesta sólida.
El modelo Medallion: Bronze, Silver y Gold en Databricks
Dentro de Databricks, el estándar de facto para organizar los datos es la arquitectura Medallion. La idea es sencilla: los datos pasan por tres capas de calidad creciente antes de llegar al dashboard.
Bronze — Datos en bruto
En esta capa se almacenan los datos tal como llegan desde los sistemas fuente, sin modificarlos. El objetivo es tener siempre disponible la fuente original.
Ejemplos de lo que entra en Bronze:
- Pedidos exportados del ERP cada noche vía API o fichero.
- Leads del CRM volcados en tiempo real.
- Datos de sesiones web desde Google Analytics 4.
- Stock de almacén extraído de un sistema legacy en CSV.
Bronze no es un vertedero. Tiene estructura (tablas Delta Lake en Databricks), pero no tiene lógica de negocio. Si algo sale mal en capas superiores, siempre puedes volver aquí y reprocesar.
Silver — Datos limpios y transformados
En Silver los datos empiezan a tener forma analítica. Esta capa es donde ocurre el trabajo más exigente: limpiar, normalizar, unir y enriquecer.
Transformaciones típicas en Silver:
- Unificar formatos de fecha entre sistemas (el ERP usa DD/MM/AAAA, el ecommerce usa timestamps Unix).
- Cruzar la tabla de pedidos con la de clientes para añadir segmento y región.
- Deduplicar registros de leads duplicados en el CRM.
- Calcular métricas derivadas: margen por línea de pedido, días desde última compra.
Al final de Silver tienes datos confiables y estructurados, pero todavía orientados a datos, no a conceptos de negocio.
Gold — Datos listos para negocio
La capa Gold contiene los modelos finales que consumen los dashboards. Aquí los datos ya hablan el idioma del negocio.
Ejemplos de tablas Gold:
ventas_por_canal_dia— ventas online y offline por día y región, con comparativa vs. año anterior.inventario_consolidado— stock disponible por referencia y almacén, con alertas de mínimo.kpis_marketing— coste por lead, tasa de conversión y ROI por campaña.metricas_financieras— margen bruto, facturación recurrente, rentabilidad por línea de producto.
La capa Gold es el contrato entre el equipo de datos y el negocio. Si un director de ventas pide «las ventas de ayer», ya sabe que la fuente de verdad está ahí — no en el Excel de alguien.
El papel de Power BI en esta arquitectura
Una vez que los datos están en Gold, Power BI se conecta directamente a esas tablas. A partir de ahí hay dos formas de trabajar:
Import mode vs. DirectQuery
Con Import, Power BI copia los datos en su motor interno y las consultas son muy rápidas. Es la opción por defecto para la mayoría de dashboards operativos.
Con DirectQuery, Power BI consulta el origen de datos directamente en cada interacción, sin necesidad de importar los datos. Útil cuando los datos se actualizan con frecuencia y necesitas ver siempre el valor más reciente, aunque requiere que la capa Gold esté bien optimizada para no penalizar el rendimiento.
La capa semántica
Lo que diferencia a Power BI de una herramienta de gráficos es la capa semántica: el modelo de datos donde defines medidas DAX, relaciones entre tablas, jerarquías y KPIs.
Capa semántica bien diseñada: En lugar de que cada analista calcule las ventas netas a su manera, defines una medida Ventas Netas en el modelo que todos comparten. Si la lógica cambia, la cambias en un solo sitio y se propaga a todos los informes. Si quieres ir un paso más allá, los dashboards adaptativos con Field Parameters te permiten que el propio usuario elija qué métrica visualizar sin necesidad de crear múltiples informes.
Por qué este enfoque escala donde los demás fallan
- Escalabilidad real: Databricks procesa desde miles hasta miles de millones de registros con el mismo pipeline.
- Gobernanza integrada: Cada capa tiene un propósito claro. Saber de dónde viene un número ya no es arqueología.
- Reutilización: La misma tabla Gold alimenta el dashboard ejecutivo, el informe de ventas y el modelo de forecasting.
- Mantenimiento centralizado: Si cambia la lógica de negocio, la cambias una vez. No en veinte Excel distintos.
¿Por dónde empezar?
- Identifica un caso de uso concreto con alto impacto y datos manejables. Por ejemplo: ventas diarias por canal en Power BI.
- Construye las tres capas para ese caso antes de expandirte. Entiende el patrón antes de replicarlo.
- Automatiza el pipeline (Databricks Jobs o Azure Data Factory) antes de añadir más fuentes.
- Itera: una vez el equipo confía en los datos del piloto, añadir nuevas fuentes es mucho más rápido.
Conclusión
Databricks + Power BI no es una combinación de moda. Es una respuesta concreta a un problema concreto: los datos del negocio crecen más rápido que la capacidad de gestionarlos con herramientas manuales.
La arquitectura Medallion (Bronze → Silver → Gold) da estructura al caos. Power BI convierte esa estructura en algo que el negocio puede usar sin intermediarios. Y el resultado es que «¿cuánto vendimos el mes pasado?» pasa de tardar dos días a tardar dos segundos.
En próximas entregas profundizaré en cómo diseñar la capa semántica sobre un modelo Gold real y cómo automatizar los pipelines de Databricks. Si tienes dudas sobre cómo aplicar esto a tu caso, escríbeme — estaré encantado de ayudarte.
¿Necesitas aplicar esto
en tu empresa?
Diseño e implemento soluciones de Power BI adaptadas a tu negocio. Hablamos sin compromiso y vemos qué tiene sentido en tu caso.
Comentarios
Deja tu comentario